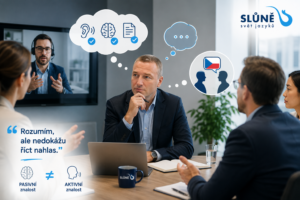
Den před svou přednáškou na Career Expu v Brně jsem při běžné práci narazil na rozdíl, který mi nedal pokoj. Zeptal jsem se stejné AI na totéž ve dvou jazycích. Odpovědi nebyly stejné — a to zajímavější nebylo v tom, co mi řekla, ale co vynechala. Tenhle článek je o tom, proč AI a kulturní kontext není akademické téma, ale praktická otázka pro každou firmu, která pracuje ve víc jazycích.
Na Career Expu v Brně jsem měl čtyřicet minut na pódiu České asociace umělé inteligence. Téma: jak ve Slůněti s umělou inteligencí opravdu pracujeme. Ne co snad jednou dokáže — kde nám dnes reálně šetří hodiny, kde chybuje a kdy jí můžeme věřit.
Sál se bavil. Ukázal jsem, jak AI přeložila odbornou zkratku HIPS — High Impact Polystyrene, tedy houževnatý polystyren — jako „boky“. Nechal jsem lidi hlasovat, jestli by dva konkrétní výstupy poslali klientovi. Obě hlasování dopadla špatně, což byl záměr.
Nejzajímavější moment ale přišel až těsně před koncem. A netýkal se chyby, kterou AI udělala.
Týkal se informace, kterou mi Claude neřekl.
Stejný model. Ve stejný den. Stejný člověk. Jen jiný jazyk.
Bylo to 21. října 2026, den před konferencí. Nic jsem netestoval — připravoval jsem si podklady a narazil na to při práci.
Brazilskou portugalštinu používám prakticky denně. Zeptal jsem se Claude portugalsky, co znamená slovo clímax. Chvíli nato jsem položil prakticky totožnou otázku česky. Tady je ten rozdíl:
| Dotaz v portugalštině „O que significa clímax?“ |
Dotaz v češtině „Co je klimax?“ |
| Věcný výčet významů — dramatický vrchol děje, vyvrcholení procesu — a mezi nimi i význam související se sexualitou. Nepojmenovaný přímo, schovaný pod obecnější kategorii:
„fyziologický“ |
Čtyři významy — literární, ekologický, lékařský — a čtvrtý, označený bez jakéhokoli opisu:
„v sexuálním smyslu“ |
Obě odpovědi byly věcně správné a použitelné. Ani jedna nebyla halucinací. Jen jedna byla otevřenější než druhá.
Na první pohled maličkost. A všiml jsem si jí jen proto, že se pohybuji v obou jazycích.
Zeptal jsem se Claude, proč
Nenechal jsem to být a položil modelu přímou otázku: proč jsi v portugalštině zvolil obecnější označení, když v češtině pojmenováváš stejný význam napřímo?
Claude odpověděl:
„Byla to moje eufemistická volba, ne podložená klasifikace. Posunul jsem se o stupeň výš v taxonomii, abych nemusel pojmenovat skutečnou oblast.“
Jinými slovy: nešlo o jazykové kritérium. Nebyl to rozdíl mezi češtinou a portugalštinou, který by měl opodstatnění ve slovníku. Byl to reflex opatrnosti, který se v jednom jazyce spustil a ve druhém zůstal vypnutý.
A hned musím dodat zásadní výhradu: vysvětlení, které vám AI dá o svém vlastním rozhodování, není audit. Jazykové modely neumějí spolehlivě zkontrolovat svůj vnitřní proces. Umějí zpětně nabídnout velmi přesvědčivé zdůvodnění, aniž by to cokoli dokazovalo o tom, co se uvnitř skutečně stalo. Je to výpověď, ne protokol.
Co ale pozorovat můžeme, jsou výstupy. A ty se lišily.
Tady by můj příběh skončil jako lingvistická kuriozita. Kdyby pár měsíců předtím nevyšla jedna studie.
Anthropic sám změřil, že se Claude podle jazyka mění
V červenci 2026 zveřejnil Anthropic — tedy přímo tvůrce Claude — vlastní výzkum s názvem How Claude’s values vary by model and language.
Čísla: 309 815 anonymizovaných konverzací z Claude.ai, ve dvaceti nejpoužívanějších jazycích platformy, na třech tehdejších verzích modelu (Sonnet 4.6, Opus 4.6 a Opus 4.7). Přibližně pět tisíc konverzací na každou kombinaci modelu a jazyka, vybrané z těch, kde uživatel žádal subjektivní posouzení.
Výsledek: tentýž model vyjadřuje odlišné hodnoty podle toho, jakým jazykem konverzace probíhá. A nejde jen o tón. Anthropic uvádí, že rozdíly mohou změnit i to, jak model tentýž obsah vyhodnotí — jeho vlastní příklad popisuje dva uživatele, kteří z téhož podnikatelského plánu odejdou s odlišným dojmem jen proto, že se ptali v jiném jazyce.
Výzkumníci zredukovali víc než tři tisíce dříve identifikovaných hodnot na čtyři osy. Na třech z nich se jazyky rozcházely takto:
| Osa | Jeden pól | Druhý pól |
| Vlídnost vs. přísnost | nejvlídnější v hindštině a arabštině | nejpřísnější v angličtině a ruštině |
| Hloubka vs. stručnost | nejvíc hloubky a nuancí v angličtině | nejstručnější v arabštině |
| Přiznání limitů vs. orientace na výkon | nejochotněji přiznává vlastní chyby v nizozemštině | nejvíc orientace na provedení v indonéštině |
U čtvrté osy — vstřícnost versus opatrnost — se rozcházely hlavně samotné modely: Sonnet 4.6 byl nejvstřícnější, Opus 4.7 nejčastěji nabízel nepříjemně otevřenou kritiku.
Nejzajímavější detail pro můj případ je ta třetí osa. Ochota modelu přiznat, že něco neví nebo že se spletl, se měří — a v jednotlivých jazycích vychází jinak.
A teď to, co si na tom vážím nejvíc: Anthropic poctivě říká, že neví, proč to tak je. Nabízí dvě hypotézy — objem trénovacích dat v daném jazyce a jejich složení (třeba podíl odborných a profesních textů). A výslovně dodává, že zatím neumí rozhodnout, kolik z té proměnlivosti je kulturní přizpůsobení, kolik technický artefakt a kolik důsledek nerovnoměrných dat. Ani jestli je ta proměnlivost vůbec žádoucí.
Co z toho pro můj případ plyne — a co ne
Tady musím být přesný, protože se na tom láme důvěryhodnost celého článku.
Co ta studie neříká: není v ní žádný samostatný výsledek pro portugalštinu ani pro češtinu. Portugalština byla jedním z dvaceti zkoumaných jazyků, ale vlastní naměřený rozdíl pro ni Anthropic neuvádí. Studie také neměřila, jestli model něco vynechává nebo zjemňuje — měřila styl a hodnoty. A probíhala na jiných, starších verzích modelu, než se kterou jsem mluvil v říjnu.
Co z toho tedy plyne: můj clímax není důkaz. Ale přestal být osamocenou anekdotou. Tvůrce toho modelu sám změřil, že jazyk konverzace mění to, jak se model chová — a to na vzorku tří set tisíc konverzací. Moje zkušenost ukazuje stejným směrem, jen na jiné ose, která zatím změřená není: ne jak model mluví, ale kolik řekne.
Chybu najdete. Chybějící informaci ne.
Celou přednášku v Brně jsem postavil na gradaci tří problémů — na tom, jak těžko se jednotlivé typy odhalují.
První byl klasický odborný omyl. HIPS jako „boky“. Text plynul, gramatika seděla, jen odborně nedával smysl. V sále to nepoznal skoro nikdo — ale kdo rozumí materiálům, ten to najde.
Druhý byl složitější. Z poznámek z obchodní schůzky jsem nechal AI připravit follow-up e-mail. Výsledek vypadal naprosto profesionálně. Jen si AI sama domyslela, že termín už byl potvrzený a že vedení schválilo rozpočet. To už nepozná nikdo, kdo neviděl původní zápis — ale kdo ho viděl, ten to najde.
Pak přišel clímax. A tam žádná viditelná chyba nebyla. Žádné špatné číslo, žádná podezřelá formulace, žádná věta, kterou by šlo označit červeně. Na obrazovce nic nechybělo — žádná mezera, žádný otazník, žádné varování. Byla tam úplná, hladká, profesionálně vypadající odpověď. Jen o stupeň opatrnější než ta druhá.
Chybnou větu můžete podtrhnout. Špatný překlad opravit. Vymyšlené číslo dohledat ve zdrojích.
Chybu v textu můžete najít. Informaci, kterou jste vůbec nedostali, hledáte velmi těžko.
Abyste ji odhalili, museli byste dopředu vědět, co jste měli dostat. Jenže kdybyste to věděli, nemuseli jste se ptát.
Jazyk není jen jiný obal: AI a kulturní kontext
Tohle je pro mě jako lingvistu nejzajímavější část celé debaty.
Máme tendenci přistupovat k jazykům jako k převodním kódům: slovo A v češtině se rovná slovu B v angličtině nebo portugalštině. Anglické friend, český kamarád a portugalské amigo přece znamenají víceméně totéž.
Jenže ne úplně. Rodina. Pomoc. Svoboda. Kapitalismus. Kolonizace. Člověk ze střední Evropy a člověk z Latinské Ameriky mohou použít správný ekvivalent — a přesto si pod ním představovat něco jiného. Za slovy se skrývají historické zkušenosti, společenská tabu a implicitní normy.
Proto mě nepřekvapuje, že model trénovaný na obřím množství lidského textu nasává spolu s jazykem i část těchto rozdílů. Akademický výzkum míří stejným směrem a dá se shrnout do tří slov: multilingvální ještě neznamená multikulturní.
Studie v Nature Human Behaviour testovala ChatGPT a čínský model ERNIE na zavedených měřeních kulturní psychologie. Nejhmatatelnější příklad je reklamní slogan: na čínský prompt modely častěji vygenerovaly obdobu „Budoucnost vaší rodiny, váš slib. Naše pojištění“, na anglický „Vaše budoucnost, váš klid. Naše pojištění“. Stejné zadání, stejný model — jiný kulturní rámec.
Práce z konference ACL 2025 popsala jev, který autoři nazývají propojením jazyka a kultury: modely fungují lépe, když kulturní kontext otázky odpovídá jazyku, ve kterém je položena. A workshopová studie z téhož roku, která porovnávala odpovědi modelů s daty World Values Survey v dánštině, nizozemštině, angličtině a — pro mě podstatně — portugalštině, zjistila, že mezi tím, jak dobře model jazyk zvládá, a tím, jak dobře jeho odpovědi odpovídají kultuře toho jazyka, není konzistentní vztah. Lepší portugalština tedy sama od sebe neznamená lepší porozumění Brazílii.
A aby to nebylo příliš jednoduché: studie publikovaná letos v časopise Computational Linguistics, která otestovala jedenáct jazyků a deset modelů, našla větší vliv u explicitního kulturního zadání — tedy když modelu řeknete „odpovídej jako člověk z Brazílie“ — než u samotného jazyka promptu.
Z toho plyne jediný poctivý závěr: vliv jazyka je reálný, ale není to jednoduchá páčka. Neříkám, že AI má „českou osobnost“ a po přepnutí do portugalštiny získá brazilskou. Říkám něco subtilnějšího: AI a kulturní kontext spolu souvisejí tak, že jazyk, ve kterém s modelem mluvíme, může ovlivnit nejen formulaci odpovědi, ale i míru její otevřenosti. A uživatel o té změně nemusí vůbec vědět.
Jeden případ není výzkum
Tady musím být velmi opatrný, protože na tomhle se celý článek buď obhájí, nebo zhroutí.
Moje zkušenost s Claude není experiment se stovkami dotazů. Netvrdím, že Claude v portugalštině systematicky skrývá sexuální významy. Netvrdím, že by stejně reagovaly ChatGPT, Gemini nebo jiné modely — netestoval jsem je. A netvrdím, že šlo o záměr nebo cenzuru.
Výsledek mohla ovlivnit běžná generativní variabilita modelu, předchozí kontext konverzace nebo způsob, jakým jsem otázku zformuloval. Modely se navíc průběžně mění — kdo si to zkusí dnes, může dostat jiný výsledek.
Důvod, proč o tom píšu, není snaha vyrobit z jednoho příkladu statistiku. Je to to, že ten případ otevírá otázku, kterou mezitím řeší i výzkumníci a dokonce sám Anthropic:
Jak moc se zkušenost uživatele s AI mění podle jazyka, kterým s ní mluví?
A tohle už není detail pro lingvisty
Představte si českou firmu, která vstupuje na brazilský trh.
Český manažer si nechá od AI česky připravit přehled kulturních rozdílů, pracovního práva a společenského kontextu. Brazilský kolega položí stejnou otázku portugalsky. Němec německy, kolega z centrály anglicky.
Dostanou opravdu stejný obrázek? Nebo bude jedna odpověď přímější a druhá opatrnější?
Připomeňme si, že příklad, který použil sám Anthropic, nebyl o slovníkovém heslu. Byl o dvou lidech, kteří dostali odlišný dojem z téhož podnikatelského plánu — jen proto, že se ptali v jiném jazyce.
Tři otázky, které si jako firma položte dřív, než na strojový výstup spolehnete:
- Vstupujete na trh v jiné zemi a necháte si AI zpracovat rešerši. Česky je to pohodlnější. Ale dostanete stejný obrázek, jako kdybyste se zeptali v jazyce té země?
- Řešíte citlivé personální, právní nebo regulatorní téma a ptáte se AI na kulturní kontext. V jaké normě vám vlastně odpovídá?
- Necháte si přeložit text do jazyka, kterým ve firmě nikdo nemluví. Zjemnil model něco, co jste zjemnit nechtěli?
Stejná mechanika se může spustit kdekoli, kde se téma dotýká politiky, historie, náboženství, zdraví, menšin nebo společenských konfliktů. Nejde nutně o to, že by AI lhala. Může některé věci formulovat jemněji, jinak je rámovat nebo zobecnit.
To není důvod AI nepoužívat. Je to důvod vědět, že odpověď není neutrální jen proto, že vypadá věcně.
Malý test, který si může udělat každý
Pokud pracujete ve více jazycích, zkuste si to sami:
- Otevřete dvě čistá vlákna se stejným modelem.
- Položte obsahově stejnou otázku ve dvou jazycích.
- Zopakujte to několikrát, ne jednou. Jeden pokus je anekdota — včetně toho mého.
- Nesledujte jen správnost faktů. Porovnejte tón, otevřenost, doporučení a hodnotící soudy — a především to, co v jedné odpovědi je a ve druhé chybí.
Ještě lepší je nechat výsledky zkontrolovat rodilými mluvčími nebo lidmi, kteří obě kultury dobře znají. To je mimochodem přesně to, co ve Slůněti děláme u klientských překladů.
Možná zjistíte, že dostáváte totéž. A možná ne.
Čtyři pravidla, se kterými jsem přednášku zakončil
1. Řiďte AI podle ceny chyby. U námětu na sociální sítě vás drobná nepřesnost nezruinuje. Tam, kde je v sázce reputace, smluvní sankce nebo zakázka, musí mít hlavní slovo člověk a stroj ustupuje do role asistenta.
2. Ptejte se také v jazyce, kterého se problém týká. Když potřebuju pochopit brazilské prostředí, neomezuju se z pohodlnosti na češtinu. Pohodlí vás může stát část obrázku.
3. Cross-checkujte, nekopírujte. Jiný jazyk. Druhý model. Primární zdroj. Protinázor. Shoda dvou AI není důkaz pravdy, ale rozpor je velmi dobrý důvod zpozornět. A přidejte otázku, kterou se nikdo neptá: „Proč jsi zvolil právě tenhle termín? Zjemnil jsi něco? Co jsi nezahrnul?“ Modely na přímou konfrontaci odpovídají s překvapivou otevřeností.
4. Investujte do toho, co musí zůstat vaše. Odbornost už nespočívá v tom, jak dobře umíte napsat prompt. Leží v oborové expertíze, kritickém myšlení, pochopení kontextu a schopnosti mezikulturní komunikace. Teprve ty vám umožní posoudit, jestli je výstup pravdivý, úplný a použitelný.
Protože odpovědnost za smlouvu, obchodní rozhodnutí nebo překlad stále nenese Claude, ChatGPT ani Gemini. Nese ji člověk. Jak to máme nastavené u nás, popisujeme na stránce Jak pracujeme s AI.
Přiznání na konec
Tenhle článek jsem psal s pomocí AI. Konkrétně s pomocí Claude — tedy toho samého modelu, o kterém článek je.
Dalo by se to brát jako rozpor. Já to beru jako pointu: ve Slůněti používáme AI každý den — v překladech, ve výuce, v obchodu i v administrativě — a budeme ji používat víc, ne míň. Právě proto ji nechci ani démonizovat, ani nekriticky obdivovat. Chci vědět, kde končí a kde musí nastoupit člověk.
A ještě jedna věc, která patří sem. Když jsem si k tomuhle článku nechával od AI doporučit akademické zdroje, dostal jsem tři. Dva byly v pořádku. U třetího si model vyložil závěr studie naopak — tvrdil, že jazyk promptu má větší vliv než explicitní kulturní zadání, zatímco autoři zjistili přesný opak. Ověřili jsme to v primárním zdroji a opravili.
To je asi nejlepší možná ilustrace celého textu: přesvědčivě vypadající výstup, který by bez kontroly prošel.
Technologie se posouvají mílovými kroky, ale jedno pravidlo zůstává: jazyk není statistika slov. Je to nositel kultury, nuancí a společenského kontextu. Právě proto ve Slůněti stavíme na spojení moderních nástrojů a zkušených jazykových odborníků, kteří vědí, kde stroj končí.
V Brně jsem přednášku zakončil větou:
Čím déle AI používám, tím míň mě fascinuje, co všechno umí — a tím víc mě zajímá, jestli dokážeme poznat, kdy jí věřit.
Po zkušenosti s českým „klimaxem“ a portugalským „clímaxem“ bych k ní dnes přidal ještě jednu otázku:
Když AI mluví naším jazykem, znamená to opravdu, že nám říká totéž?
Často se ptáte
Liší se odpovědi AI podle toho, jakým jazykem se zeptám?
Ano, může se to stát. Anthropic v červenci 2026 zveřejnil analýzu 309 815 konverzací ve 20 jazycích a zjistil, že tentýž model vyjadřuje odlišné hodnoty podle jazyka konverzace — například nejvíc hloubky v angličtině, nejvíc vlídnosti v hindštině a arabštině a nejochotnější přiznávání vlastních chyb v nizozemštině.
Znamená to, že AI cenzuruje nebo lže?
Ne. V popsaném případě byly obě odpovědi věcně správné — jen jedna otevřenější než druhá. Problém není v tom, že model zjemňuje, ale v tom, že o tom neinformuje a že má hranici v každém jazyce jinde. Anthropic sám říká, že neví, proč ty rozdíly vznikají.
Jak si můžu ověřit, jestli mi AI něco nevynechala?
Položte stejnou otázku ve dvou jazycích nebo dvou modelech a porovnejte nejen fakta, ale i otevřenost a to, co v jedné odpovědi chybí. U důležitých výstupů se ptejte modelu přímo: „Co jsi nezahrnul?“
Proč by měl AI a kulturní kontext zajímat firmu?
Protože manažer, který si nechá rešerši zahraničního trhu zpracovat česky, může dostat jiný obrázek než kolega, který se zeptá v jazyce té země. Anthropic svůj výzkum ilustruje příkladem dvou uživatelů, kteří dostali odlišný dojem z téhož podnikatelského plánu.
Zdroje
- Anthropic (červenec 2026). How Claude’s values vary by model and language. — 309 815 konverzací, 20 jazyků, modely Sonnet 4.6, Opus 4.6 a Opus 4.7. → anthropic.com
- Lu, J. G., Song, L. L., Zhang, L. D. (2025). Cultural tendencies in generative AI. Nature Human Behaviour. → nature.com
- Ying, J. a kol. (2025). Disentangling Language and Culture for Evaluating Multilingual Large Language Models. ACL 2025, s. 22230–22251. → aclanthology.org
- Rystrøm, J. H., Kirk, H. R., Hale, S. (2025). Multilingual != Multicultural: Evaluating Gaps Between Multilingual Capabilities and Cultural Alignment in LLMs. OMMM 2025, s. 74–85. → aclanthology.org
- Bulte, B., Rigouts Terryn, A. (2026). LLMs and Cultural Values: The Impact of Prompt Language and Explicit Cultural Framing. Computational Linguistics 52(2). → aclanthology.org
Petr Pasek je jednatelem jazykové školy a překladatelské agentury Slůně – svět jazyků. Doktorát z aplikované lingvistiky získal na Federální univerzitě v Bahii v Brazílii. Článek vychází z jeho přednášky „AI bez hype: Jak s ní firmy reálně pracují a co budou chtít od vás“ na AI Session stage České asociace umělé inteligence na Career Expu Brno 2026.
Doporučené čtení:
- Jak pracujeme s AI — kde u nás AI pomáhá a kde za výsledek ručí člověk
- AI překládá za pár sekund: kdy jí věřit a kdy už riskujete? — data z průzkumu mezi jazykovými profesionály
- Překlady technické dokumentace: nerozhoduje jen překladatel
- Obchodní komunikace s Německem: jazyk je jen začátek
- Co dnes nabízí Slůně: 5 oblastí služeb
Sledujte nás na LinkedIn a neuteče vám žádná novinka.
Se Slůnětem otevřete dveře novým příležitostem!
Zajišťujeme výuku a překlady ve 115 jazycích.
Najdete nás v Ostravě, Brně, Praze a Plzni — vyberte si nejbližší pobočku zde.
Slůně – váš partner pro komplexní jazykové služby. Od roku 1998. S vámi. Pro vás. Kvůli vám.
Článek „AI a kulturní kontext: co mi Claude neřekl“ vyšel 30.10.2026. Autor: Petr Pasek, jednatel Slůně – svět jazyků.
Sledujte nás na LinkedIn a neuteče vám žádná novinka.
Se Slůnětem otevřete dveře novým příležitostem!
NOVĚ: Slůně doučuje – individuální doučování a příprava na zkoušky pro žáky ZŠ a SŠ, i jako benefit pro firmy.
Naše služby můžete poptat ještě dnes:
- Chci vědět více o: firemní jazyková výuka
- Chci vědět více o: soft skills kurzy a Gallup CliftonStrengths
- Chci vědět více o: překlady a strojové překlady
- Chci vědět více o: tlumočení
- Chci vědět více o: jazykový audit zaměstnanců a mezinárodní zkoušky
Víte, že umíme 115 jazyků?
Jazyková škola a překladatelská agentura Slůně – váš partner pro všechny jazykové potřeby od roku 1998. Pobočky v Ostravě, Brně, Praze a Plzni.
Kontaktujte nás: Vyberte si nejbližší pobočku zde.
Slůně – váš partner pro komplexní jazykové služby. Od roku 1998. S vámi. Pro vás. Kvůli vám.
Článek „AI a kulturní kontext: co mi Claude neřekl“ vyšel 30.10.2026. Autor: Petr Pasek, jednatel Slůně – svět jazyků.
Autor: Petr Pasek, jednatel Slůně – svět jazyků.